Tessera
모든 분기가 기록에 남는
AI 에이전트 오케스트레이션
엔지니어링 팀이 AI 에이전트 작업을 실행하고, 승인하고, 기록을 검토할 수 있게 하는 소프트웨어입니다. 분기 판단만 확률 모델에게 맡기고, 제어 흐름·규칙·한계는 전부 코드가 소유합니다. 각 결정은 확률·문턱·덮어쓴 규칙까지 담아 남습니다.
개발 중Claude API 통합 계획 보기- Python 하네스
- Rust · Tauri 데스크톱
- SQLite 체크포인트 · 감사 로그
- TypeSafe Jev 라우팅
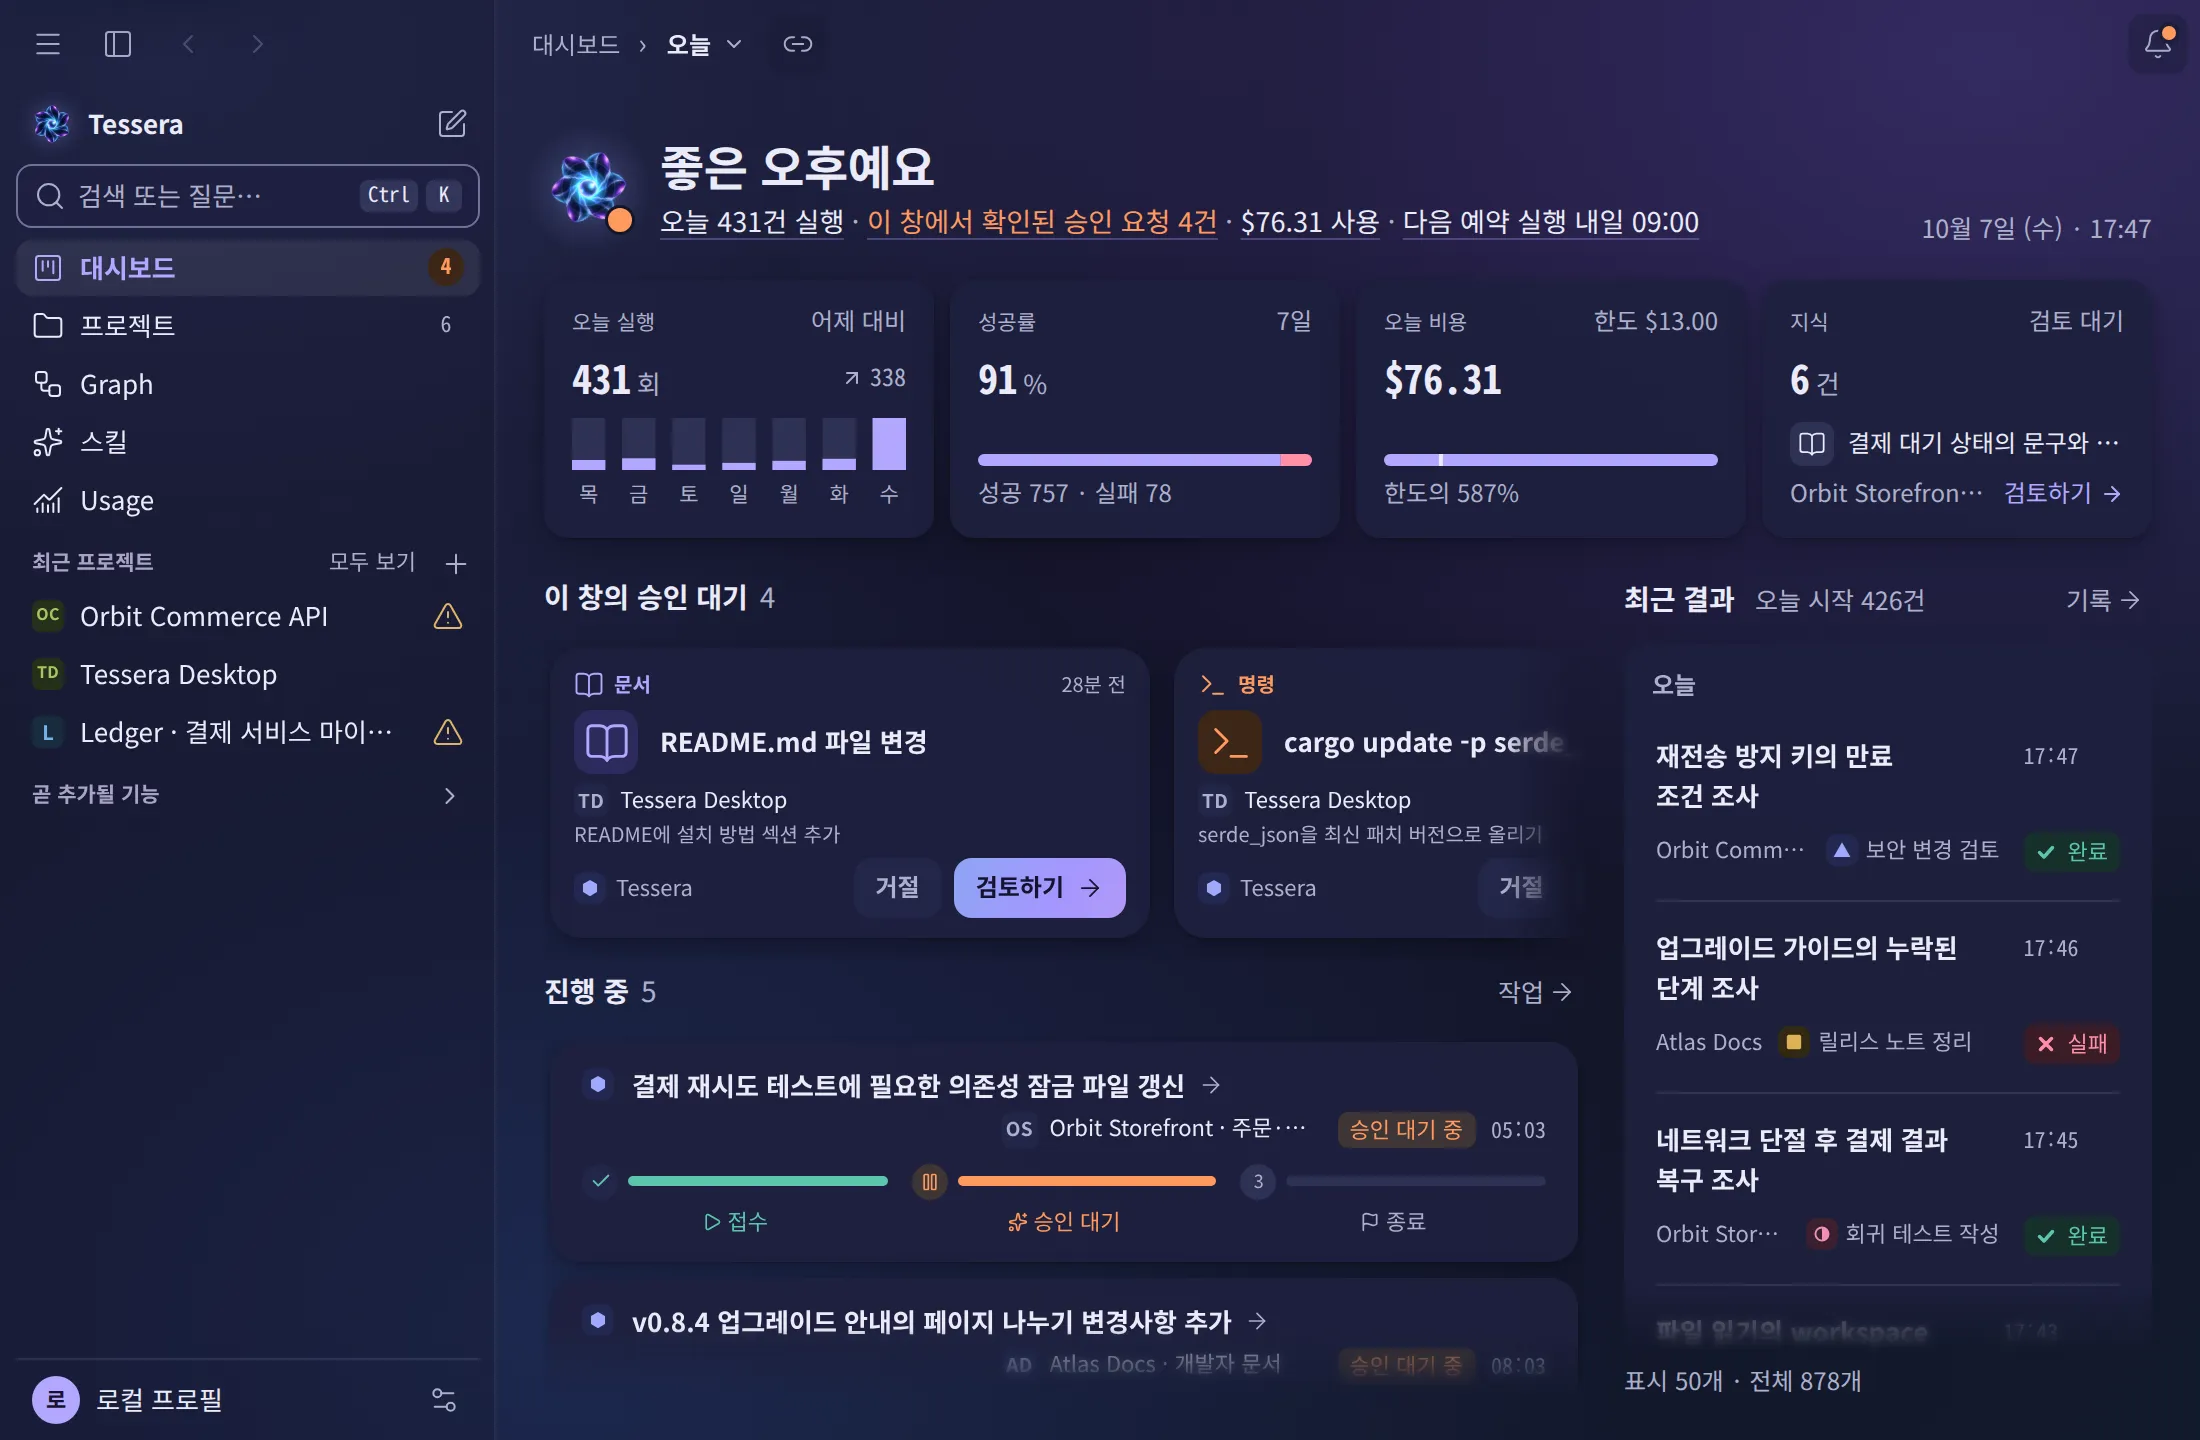
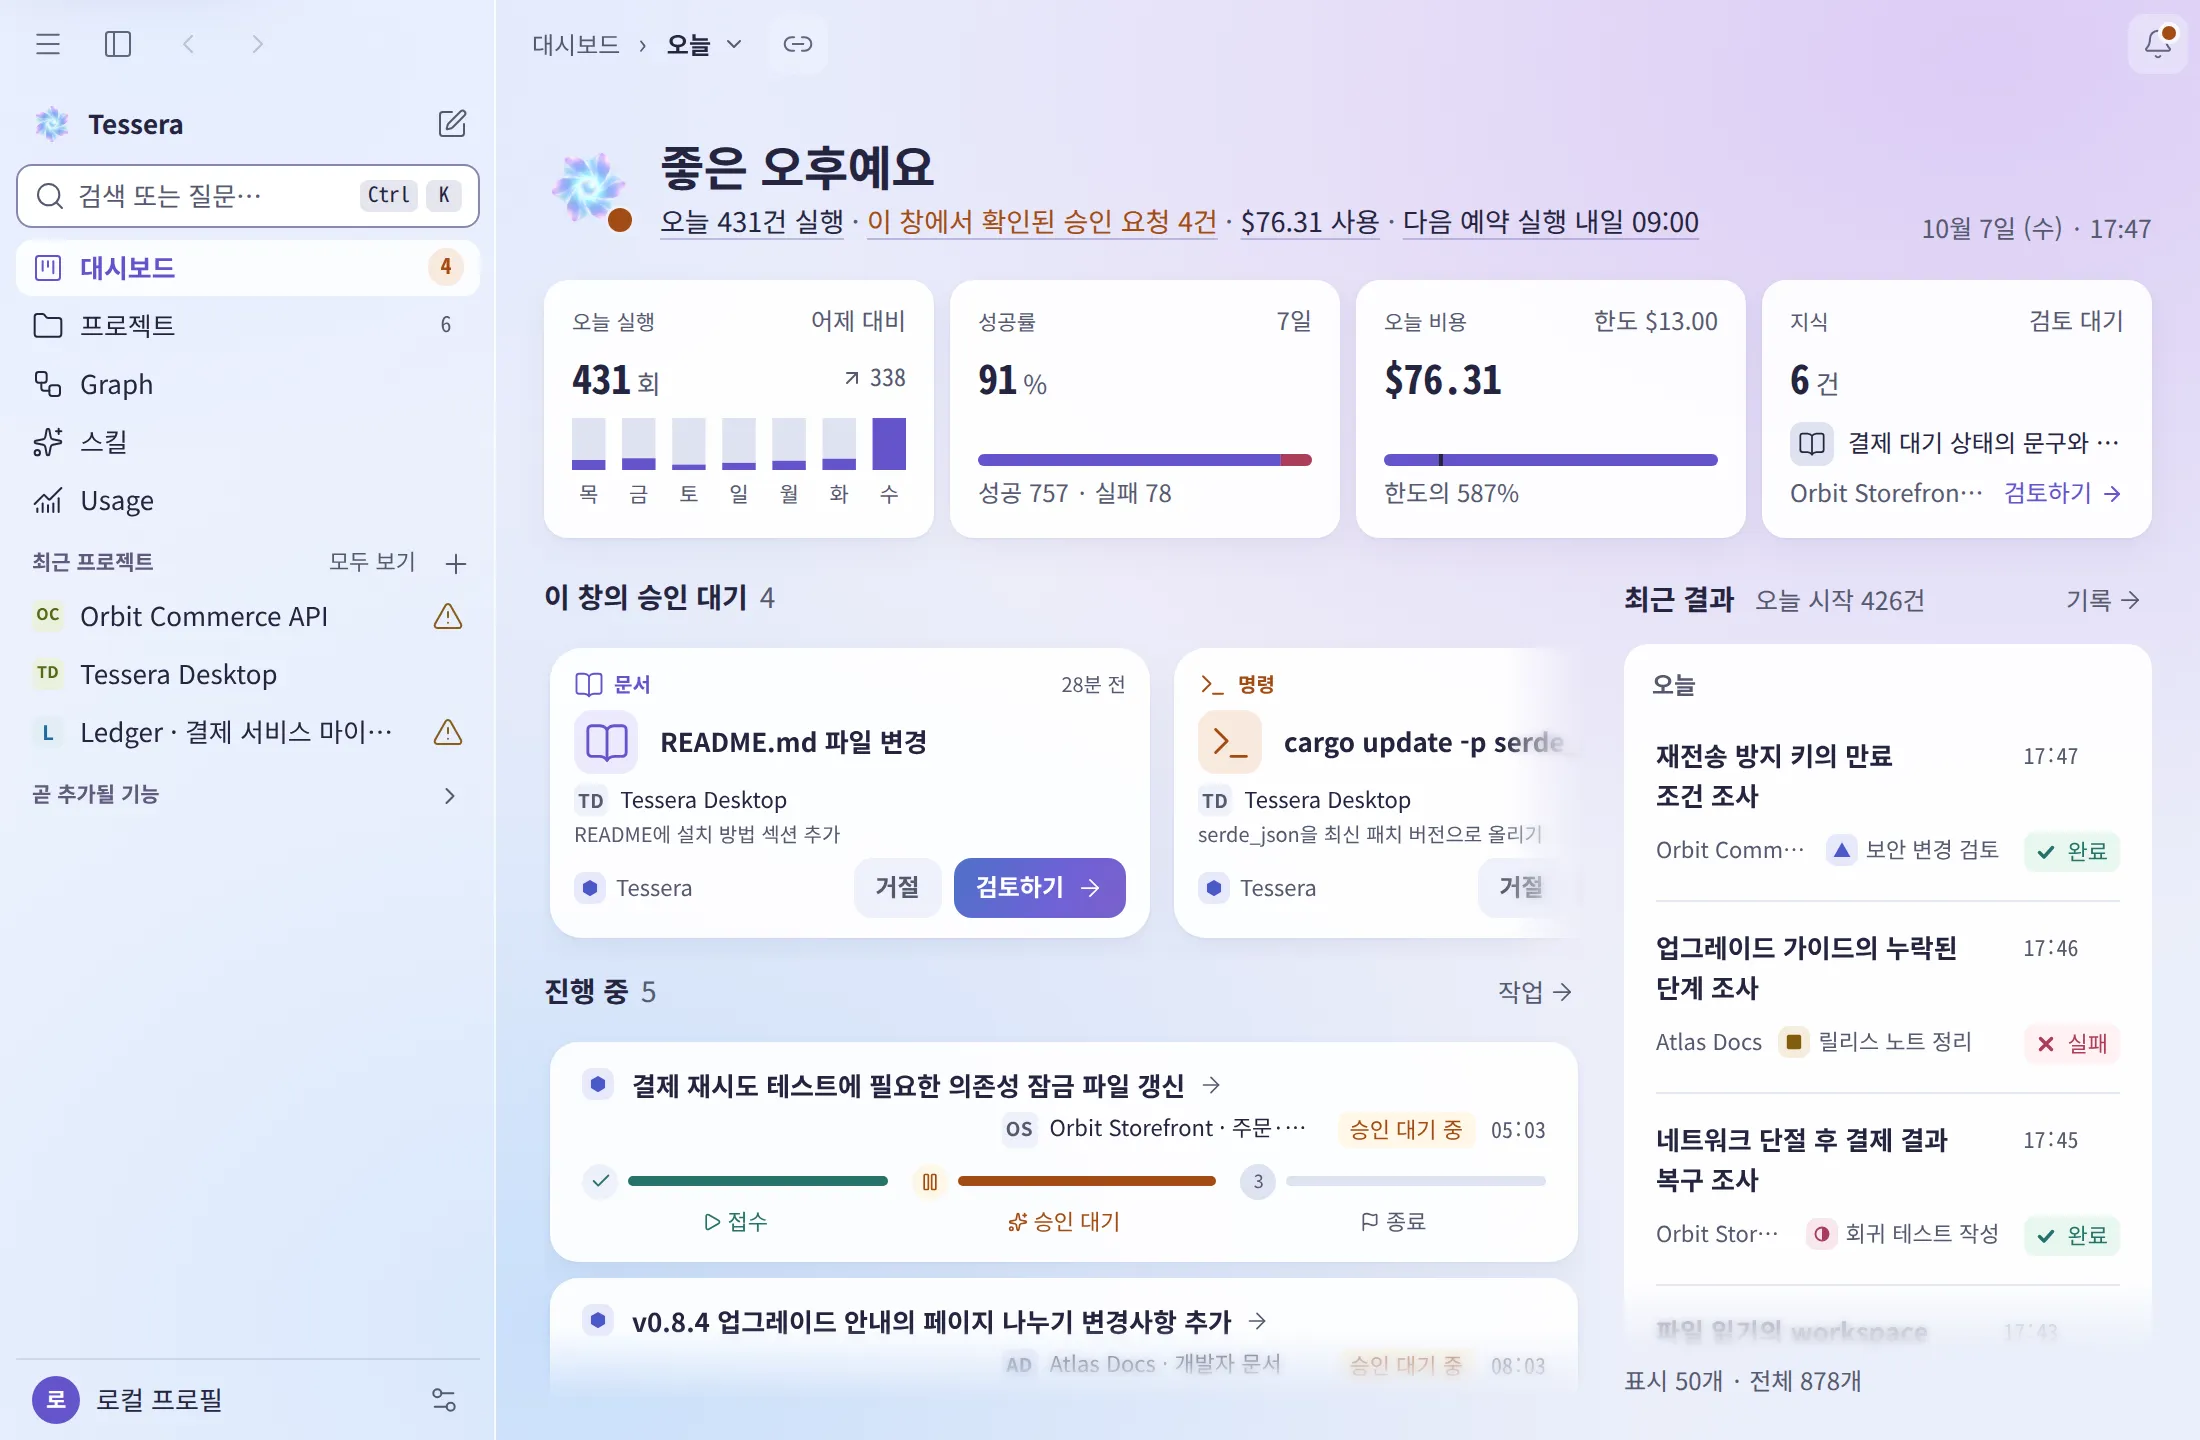
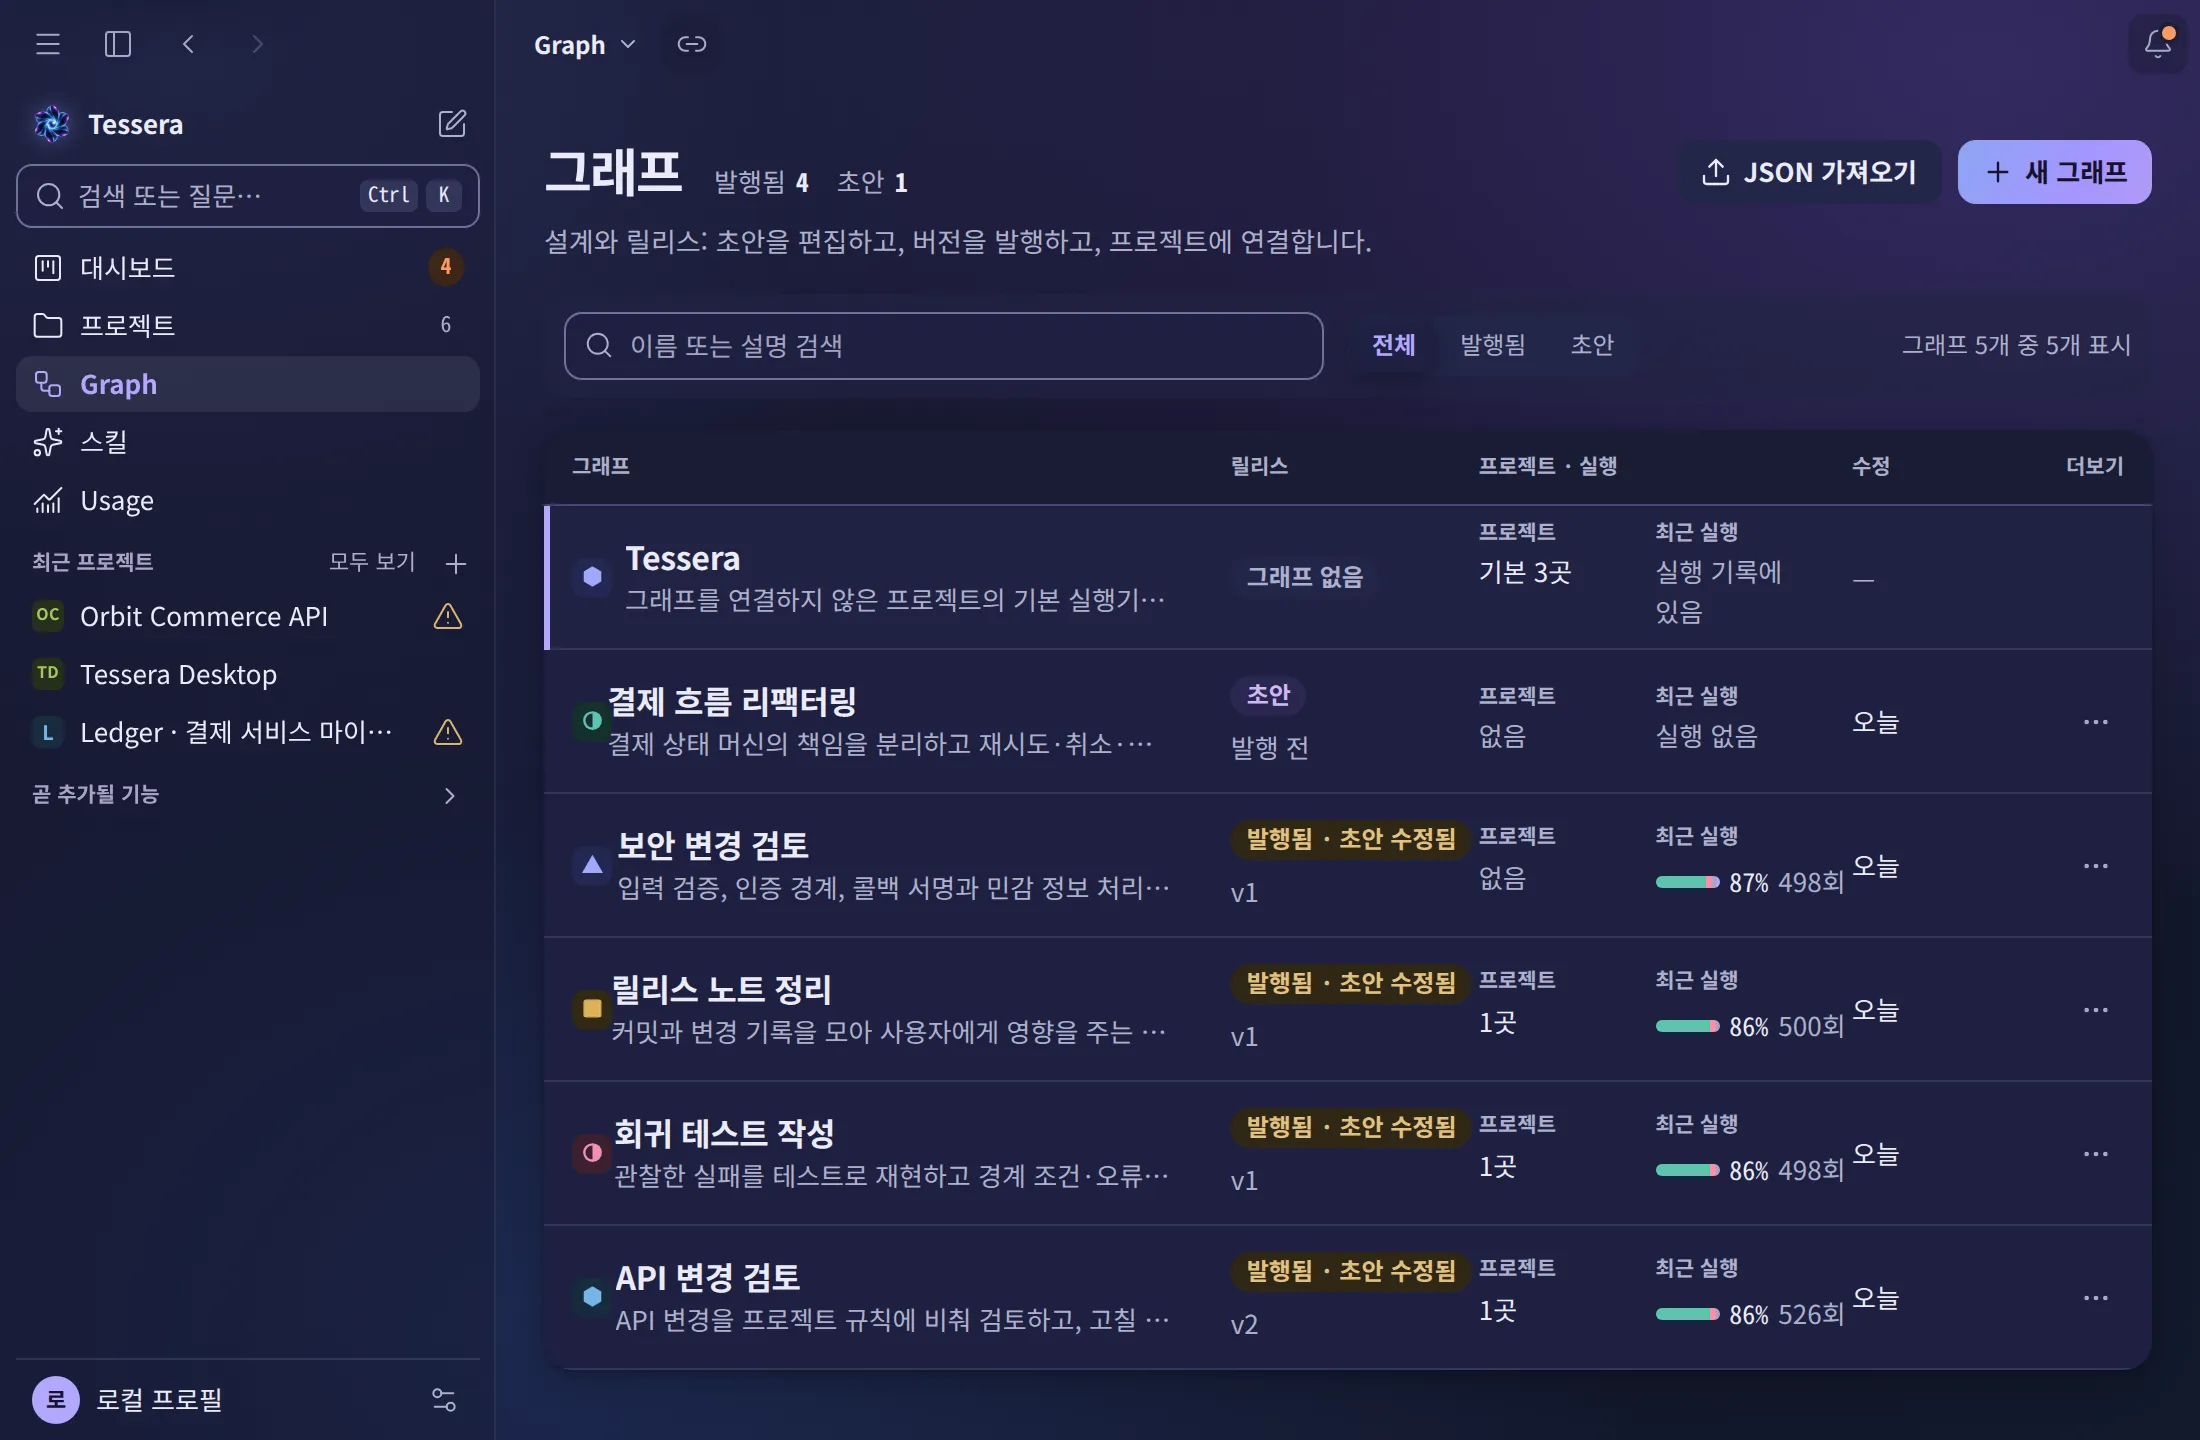
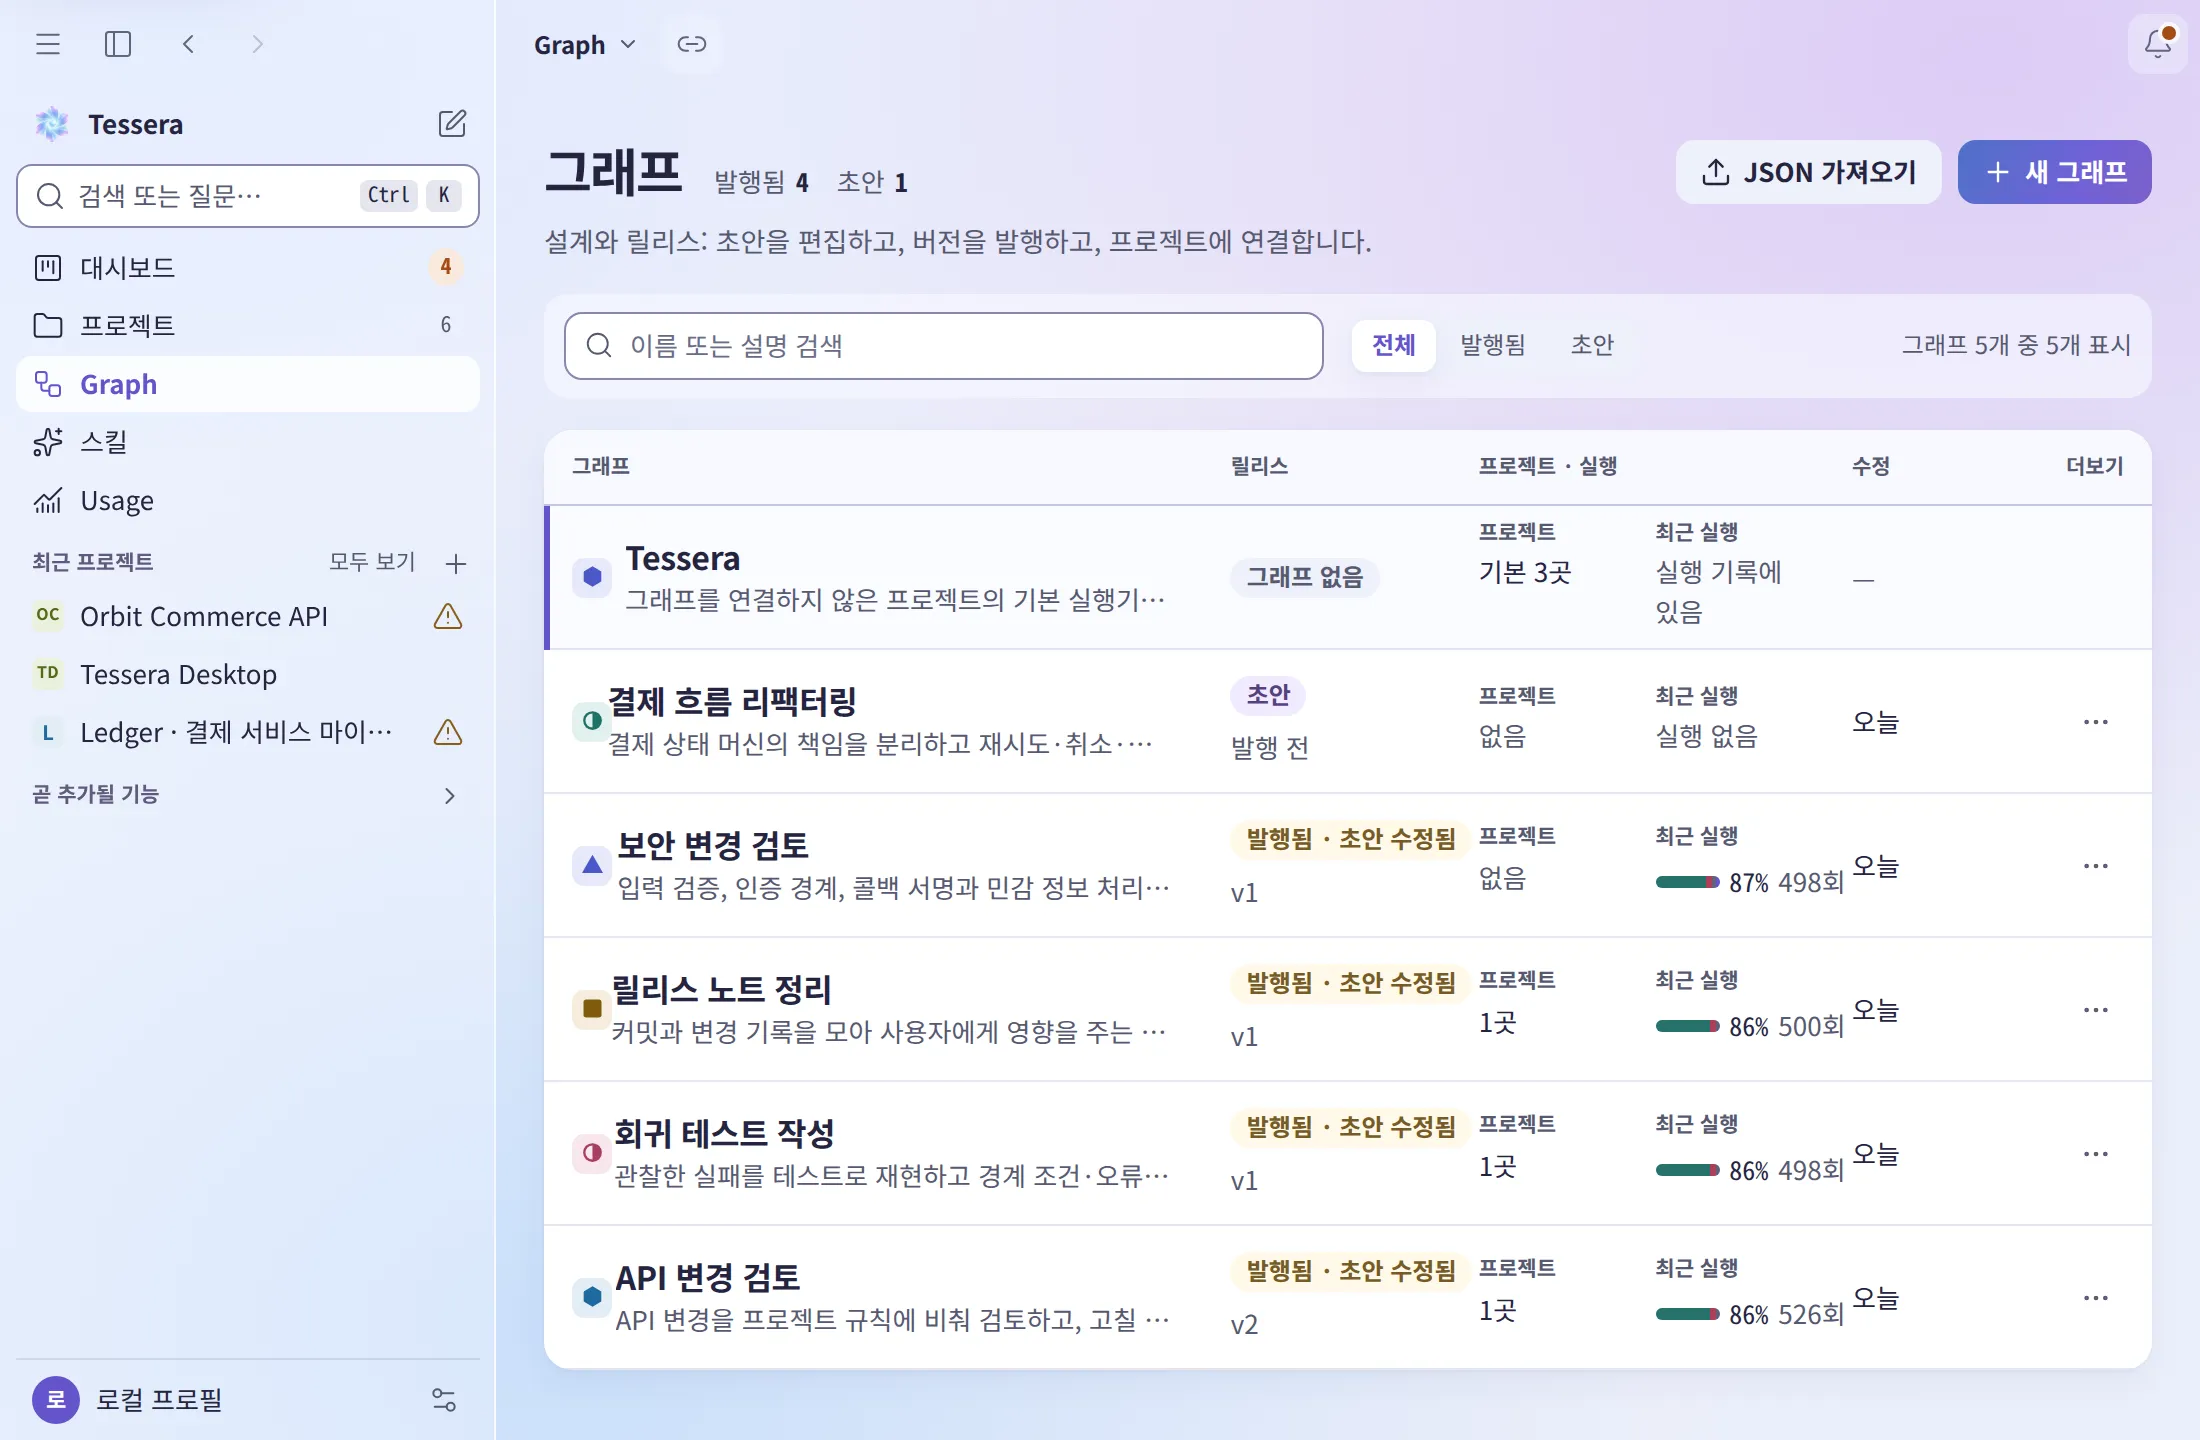
데스크톱 앱 화면 (데모 데이터)
일은 노드가, 판단은 Jev가, 결정은 코드가
조건부 엣지는 그래프 하네스에서 가장 애매한 지점입니다. 보통은 LLM에게 "다음에 뭘 할까?"를 묻고 텍스트를 파싱하지만, Tessera는 텍스트 대신 정해진 선택지 위의 확률을 받습니다.
- 01Node
노드가 일을 합니다
LLM 호출, 코드, 툴 실행 — 실제 작업은 노드가 하고, 결과는 채널별 리듀서로 State에 병합됩니다.
- 02Jev · 1 call
Jev가 분기를 판단합니다
"어느 분기로?"와 가드 질문들을 Jev 호출 한 번에 병렬로 묻고, 정해진 선택지 위의 확률 분포를 받습니다. 스키마 밖의 값은 나올 수 없습니다.
- 03Code
코드가 다음을 결정합니다
분기별 문턱, 예산, 덮어쓰기 규칙은 순수 파이썬입니다. 결정은 확률·문턱·적용된 규칙과 함께 Decision으로 남습니다.
모델이 골라도, 문턱을 못 넘으면 사람에게
장애 대응 예제에서 증거 두 줄을 캐고 나자 모델은 patch를 골랐습니다. 그런데 확률은 0.62, 되돌릴 수 없는 분기의 문턱은 0.85입니다. 그래서 코드가 사람에게 넘겼습니다.
모델이 계속 investigate만 골라도 런은 끝납니다. 끝내는 건 모델이 아니라 예산 규칙입니다. 확률은 실행마다 조금씩 흔들립니다.
investigate  {'investigate': 1.0, 'patch': 0.0}  conf 1.00/0.70  -> investigate
investigate  {'patch': 0.0, 'investigate': 1.0}  conf 1.00/0.70  -> investigate
patch        {'investigate': 0.38, 'patch': 0.62}  conf 0.24/0.85  -> escalate confidence
6 supersteps, status=done통제와 기록을 위한 기본기
상태, 그래프, 실행기, 체크포인트, 감사 로그, 게이트 — 하네스 코어는 작고, 각자 한 가지 책임만 집니다.
분기마다 다른 문턱
되돌릴 수 없는 분기에는 더 높은 확신을 요구합니다. 문턱을 못 넘으면 on_uncertain으로 지정한 곳 — 보통 사람 — 에게 넘깁니다.
min_confidence={"patch": 0.85, "*": 0.70}코드가 마지막 말을 합니다
decide 훅으로 모델의 선택을 규칙이 덮어쓸 수 있고, 덮어쓴 이유까지 기록됩니다. 모델이 1.00으로 확신해도 예산은 못 넘습니다.
decide=budgetSuperstep 실행
프런티어의 노드를 동시에 실행하고, 병합하고, 엣지를 풀어 다음 프런티어를 정합니다. fan-out, 조인 배리어, 오류 격리, 재시도가 이 루프에서 나옵니다.
add_edge(["b", "c"], "d")체크포인트와 재개
superstep 경계마다 state와 frontier를 SQLite에 스냅샷합니다. 한도에 걸려 멈춰도 부분 결과가 살아 있고, 같은 thread_id로 이어서 실행합니다.
SqliteCheckpointer("runs.sqlite")감사 로그
라우팅 결정은 append-only 로그에 남습니다. SqliteAuditLog를 붙이면 그 기록이 프로세스보다 오래 삽니다.
SqliteAuditLog사람에게 넘기고, 나중에 이어서
확신이 부족하면 런을 일시정지하고 체크포인트에 남깁니다. 사람이 증거를 보태면, 분기를 대신 고르지 않고 그 위에서 질문을 다시 던집니다.
on_uncertain=PAUSE
터미널에서도, 데스크톱에서도
하네스 위에 올린 실제 프로그램입니다. 터미널 코딩 에이전트 tessera-agent와 데스크톱 앱이 같은 에이전트 루프를 씁니다.
tessera-agent
화면을 뺏지 않는 터미널 에이전트. alt-screen을 쓰지 않아 스크롤백이라는 기록을 버리지 않습니다. 세션·감사 기록 조회와 재개 명령이 붙어 있습니다.
❯ median()이 짝수 길이에서 틀렸다. 고치고 검증해라
▸ shell: cat -n stats.py
수정 전에 현재 구현을 확인한다
checked read-only shape
▸ run 0.98
ask ░░░░░░░░░░░░░░░░░░ 0.01
refuse ░░░░░░░░░░░░░░░░░░ 0.01
conf 0.97/0.30 margin 0.97 590ms
→ run데스크톱 앱
그래프를 초안으로 편집하고, 버전으로 발행해 프로젝트에 연결합니다. 승인 대기, 실행 타임라인과 결정 기록, 비용을 한 앱에서 봅니다.
저장소 작업은 Claude가, 실행 통제는 Tessera가
Tessera에 Anthropic의 Claude Messages API를 통합하고 있습니다. AI 코딩 작업의 실행과 결과를 통제하고 확인하려는 엔지니어링 팀이, 통제된 작업 흐름 안에서 저장소 문맥을 분석하고 코드 변경을 제안받고 테스트를 생성할 수 있게 하는 것이 목표입니다.
- 구현됨Anthropic Messages API 어댑터
- 개발·검증 중Claude를 이용한 전체 작업 흐름
- 01작업 요청엔지니어
- 02저장소 문맥 분석Claude
- 03변경 제안Claude
- 04필요한 승인Tessera 정책 · 사람
- 05실행Tessera
- 06테스트 및 결과 확인Claude 테스트 생성 · Tessera 실행·기록
Claude가 맡을 일
개발 중- 코드 이해 — 저장소 문맥 분석
- 코드 변경 제안
- 테스트 생성
Tessera가 맡는 일
기존 기능- 도구 실행
- 정책과 승인
- 예산
- 감사 기록
- 체크포인트와 재개
분기 판단을 맡는 Jev 라우터(위의 동작 방식)와는 별개의 역할입니다. Claude는 분기를 고르는 것이 아니라 저장소 작업 자체를 수행합니다.
다음 목표: 평가된 프로토타입
아래 기준으로 측정합니다.
- 작업 완료 여부
- 테스트 결과
- 지연 시간
- 완료 작업당 API 비용
- 실패·중단 후 복구
We are integrating Claude’s Messages API into Tessera so engineering teams can analyze repository context, propose code changes, and generate tests within a controlled workflow. Tessera manages tool execution, approvals, budgets, audit records, and checkpoint/resume. An API adapter is implemented; the complete Claude workflow is under development. Our next milestone is an evaluated prototype, measured by task completion, test outcomes, latency, API cost per completed task, and recovery from failed or interrupted runs.
그냥 LLM에게 물으면 어떻게 될까 — 재 봤습니다
같은 33개 라벨 케이스를 Jev과 LLM 직답에 동일한 지시·선택지·상태로 던졌습니다. 유리한 숫자만 고르지 않고 그대로 옮깁니다.
| 지표 | Jev (Tessera) | LLM 직답 |
|---|---|---|
| 지연 p50 (wall) | 265ms | 2,810ms |
| 결정 1건당 비용 | $0.000025 | $0.00136 (55배) |
| 응답을 그대로 json.loads 실패 | 0 / 99 | 99 / 99 |
| ECE (strict, 3rep) | 0.140 | 0.267 |
| strict 정확도 | 78.8% | 90.9% |
| lenient 정확도 | 93.9% | 93.9% |
- 이 비교는 분기 판단(라우팅) 용도에 한정한 실험입니다. 위에서 설명한 Claude의 역할(저장소 작업 수행)을 평가한 것이 아닙니다.
- 자체 측정입니다. 비교 대상은
claude-haiku-4-5직답(툴 off), 855레코드입니다. 벤더는 지연 수치를 공표하지 않습니다. - strict 정확도는 LLM이 앞섰습니다. 다만 McNemar 정확검정 p = 0.289로 유의하지 않고(n=33, 라벨은 한 사람이 작성), 이 데이터로 어느 쪽이 더 정확하다고 말할 수 없습니다.
- Tessera가 기대는 건 정확도가 아니라 지연·비용·파싱 안정성, 그리고 확률이 있어야 걸 수 있는 문턱입니다.
Tessera가 하지 않는 것
막는 것과 못 막는 것을 구분해 적어 둡니다.
confidence 게이트는 보안 통제가 아닙니다
진짜 로그처럼 보이는 날조된 관측 앞에서 모델은 확신하고, 문턱은 그걸 잡지 못합니다(측정 성공률 81~87%). 효과가 있었던 방어는 수집 시점의 출처 분리였습니다.
모델에게 주지 않은 사실은 복원되지 않습니다
신뢰 영역 안의 날조와 선택적 생략은 프롬프트가 아니라 정보 부재의 문제입니다. 출처 태깅 같은 수집 계층의 책임으로 남겨 둡니다.
아직 없는 것
per-branch state를 갖는 동적 fan-out은 아직 지원하지 않습니다. 한 스텝에서 같은 노드를 N번 돌릴 수 없습니다.
Tessera 대기열에 등록하세요
공개 준비가 되면 등록하신 메일로 먼저 알려 드립니다. 출시 일정은 아직 정하지 않았고, 안내 외의 용도로 메일을 보내지 않습니다.
등록 정보 삭제를 원하시면 [email protected]로 알려 주세요.
Tessera 도입을 검토하고 있나요?
팀의 에이전트 워크플로에 맞는지, 어떤 결정에 문턱을 걸어야 하는지 함께 살펴봅니다.